Er data är skillnaden
Om konkurrenten köper samma AI som ni, vad gör er då unika?
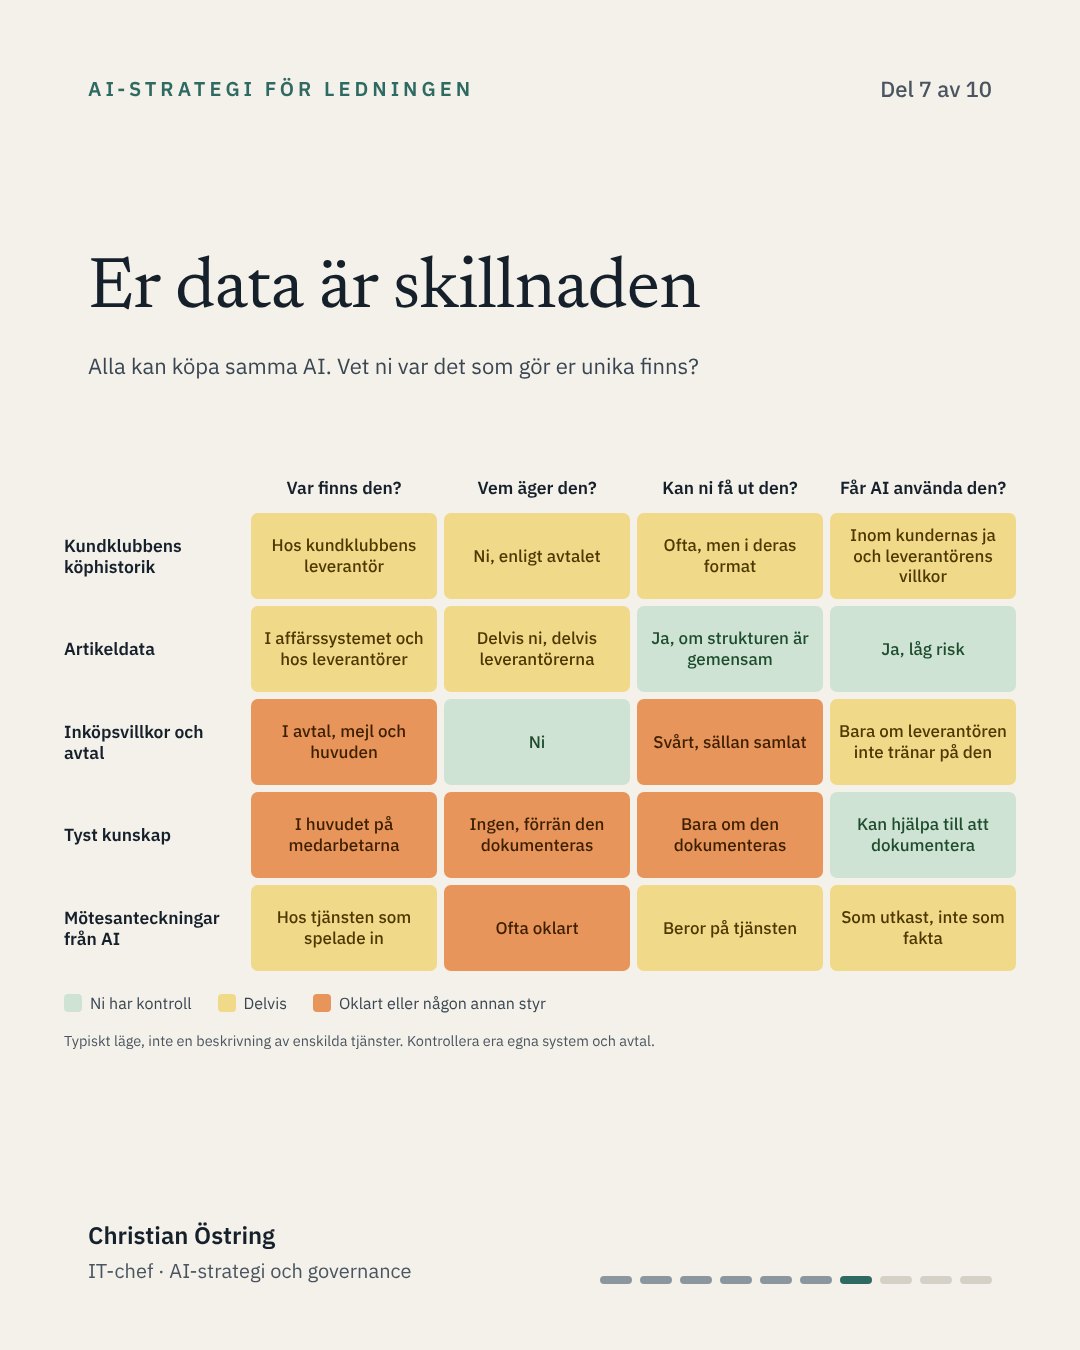
Alla som betalar kan använda samma AI-modeller. Det som skiljer är vad man ger dem att jobba med: kunddata, artikeldata, inköpsvillkor och allt som finns i huvudet på medarbetarna.
I handeln är det ofta sådant som har byggts upp i det tysta i åratal. Kundernas köphistorik i kundklubben, och att de har sagt ja till att få erbjudanden. Artikeldatan som någon har rättat och kompletterat, leverantör för leverantör. Det kan en konkurrent inte köpa.
Men datan måste gå att förstå. Jag har sett kundklubbar som tog emot köphistorik från butiker med olika kassasystem, och även från butiker med samma kassasystem men olika artikelnummer och varugrupper. Samma artikelnummer kunde vara en glass i en butik och en hink färg i en annan. Då går det knappt att få ut någon statistik, och AI gör det inte bättre.
Så här skulle jag tänka kring den datan
- Tyst kunskapMycket av det som får verksamheten att fungera är aldrig nedskrivet. Jag har sett affärssystembyten där det svåraste inte var tekniken, utan att ingen längre visste varför en viss regel fanns. Den kunskapen behöver skrivas ner, med eller utan AI.
- Rätten till er egen dataMycket ligger i olika molntjänster, och i samma bransch använder konkurrenterna ofta samma system. Vad säger avtalen om att få ut datan, och i vilket format? Och får leverantören träna sina modeller på den? Gör den det kan er kunskap och historik indirekt komma även era konkurrenter till del, och mest förlorar den som har kommit längst.
- Ordning före AIAI blir aldrig bättre än informationen den kommer åt. Att klassa varje dokument för sig hinner ingen. Jag skulle börja per system: vad är öppet, internt, konfidentiellt eller känsligt i affärssystemet, i kundklubben och på den gemensamma lagringen? Det är grovt, men det räcker långt för att veta vad AI får komma åt.
- Mötesanteckningar från AIAllt fler möten spelas in och skrivs ut av AI. Utskriften innehåller ofta fel, och när den sparas kan andra AI-verktyg senare läsa den som fakta, utan att veta vem som sa vad eller om det var ett beslut eller bara en tanke. Jag skulle se den som ett utkast, inte ett protokoll: märkt som AI, kollad av deltagarna och rensad efter en tid.
Det är samma fråga som i del 1: vem äger den? Äger ni datan, eller bara tillgången till den?
Texten är skriven av mig med stöd av AI för research, struktur och språk. Slutsatserna och ansvaret är mina.
Vill du prata om hur det här ser ut hos er?